18 年了。自從 2011 年 Xserve 停產、蘋果正式退出伺服器硬體市場以來,Cupertino 從未認真考慮過回頭——直到 AI 時代把一切都改寫。《The Information》週三獨家報導,蘋果正在開發一款企業級 AI 伺服器,核心是尚未發表的 M8 Ultra 晶片,並且已經與輝達(Nvidia)洽談導入 NVLink Fusion 互連技術,目標 2029 年推向市場。
這不是普通的產品更新,而是一次戰略級的板塊移動:當 OpenAI 為了訓練 AI 代理而買下數萬台 Mac mini、當 Apple Silicon 的每瓦推論效率成為業界公認的護城河,蘋果終於決定把這塊晶片優勢,從你的桌面搬進企業的機房。
報導內容:M8 Ultra 上機,2 顆或 4 顆
根據《The Information》引述知情人士的說法,這款 AI 伺服器將採用蘋果計畫中的 M8 Ultra 晶片——預計是蘋果史上效能最強的處理器。產品定位是賣給 AI 開發者、企業與政府客戶,用於 AI 推論(inference)工作負載,而非與輝達正面搶奧運級的模型訓大賽。
消息人士透露,目前內部評估的配置有兩種:2 顆 M8 Ultra 與 4 顆 M8 Ultra。多顆晶片協同工作需要高效互連,這正是輝達 NVLink Fusion 技術的用武之地——它讓多顆晶片以極高頻寬、極低延遲的方式「手牽手」組成統一的運算池。路透社、MacRumors、Ars Technica 等多家媒體已跟進證實這項消息。
為什麼是現在?Apple Silicon 的推論優勢
蘋果重返伺服器市場的底氣,來自過去兩年一個極不尋常的現象:客戶用真金白銀投票,證明了 Apple Silicon 的推論效率。
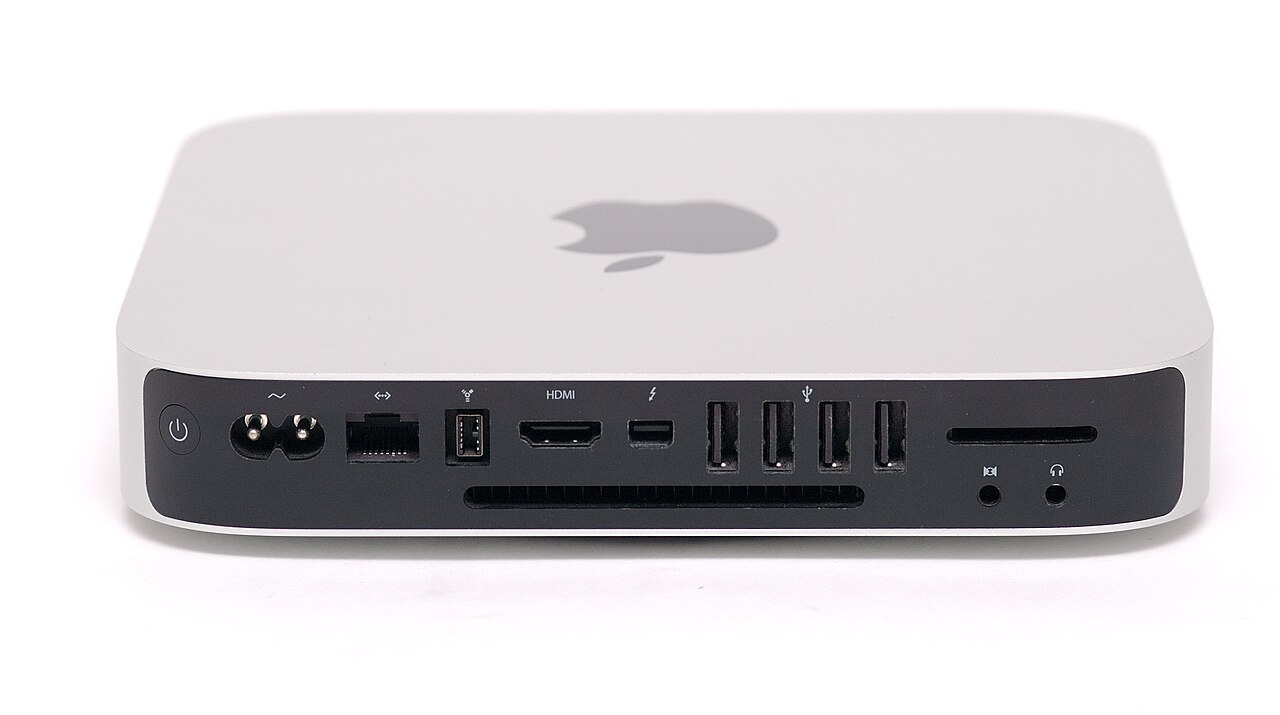
最戲劇性的例子正是 OpenAI。今年 9 月初,多家媒體報導 OpenAI 為了訓練 AI 代理(agent)買下「數萬台」Mac mini,引發全球 Mac mini 缺貨潮——而諷刺的是,同一時間蘋果正因商業機密竊取案與 OpenAI 對簿公堂。客戶一邊告你、一邊搶買你的機器,這是 Apple Silicon 最好的背書。
業界分析普遍認為,M 系列晶片的統一記憶體架構(unified memory)與每瓦效能,在推論場景遠優於傳統 GPU 伺服器——推論不需要最快的單點算力,而是需要用最低的成本跑最多的請求。當 AI 應用從「煉丹」轉向「量產」,推論市場的規模將遠超訓練市場,而這正是蘋果最擅長的戰場。
與輝達共舞:敵人的敵人就是夥伴
最耐人尋味的,是蘋果與輝達這對「世仇」的破冰。
兩家公司的恩怨由來已久:專利授權糾紛、法庭交鋒、專利訴訟期間輝達要求蘋果交出銷售數據,2010 年代初關係徹底破裂後,蘋果在 Mac 產品線上冷落輝達超過十年,最終在 2020 年全面轉向自研 Apple Silicon。如今在 AI 伺服器上重新坐上談判桌,說明在絕對的工程現實面前,商業恩怨可以暫時放下。
NVLink Fusion 是輝達 2025 年推出的開放版 NVLink 生態,允許第三方 CPU/ASIC 接入輝達的互連體系。對蘋果而言,導入成熟的互連方案可以省下自研的時間與風險;對輝達而言,超過一半資料中心營收來自網路設備的它,樂見任何擴大 NVLink 生態的機會——即使對方是蘋果。Yahoo Finance 指出,輝達約五分之一的資料中心營收來自網路設備,蘋果這一筆潛在訂單對它意義不小。
市場影響:2029 年的變數與看點
消息傳出後,市場反應正面,蘋果股價盤中上揚。但 2029 年是很遠的以後,這中間存在幾個關鍵變數:
- 配置彈性:2 顆 vs 4 顆 M8 Ultra 的取捨,反映蘋果仍在摸索客戶真實需求——企業採購要的是平衡,不是堆料。
- 生態系統:AI 伺服器買家看重軟體棧。蘋果需要證明自家工具鏈能無縫接軌 CUDA 主導的 AI 開發世界,這比造硬體更難。
- 競爭格局:2029 年的推論市場,將是輝達 GPU、AMD、Google TPU、亞馬遜自研晶片與蘋果同場競技——屆時蘋果的每瓦成本優勢是否仍在,是最大懸念。
結論:晶片戰爭的下一幕,在機房裡
蘋果這一步棋的意義,遠超一款硬體產品。它宣告 Apple Silicon 的野心不再侷限於消費裝置——當推論成本決定 AI 應用的生死,擁有業界最佳每瓦效能的蘋果,沒有理由把機房的錢讓給別人。
對企業與開發者而言,2029 年多一個強力選項當然是好事;對投資者而言,這是觀察蘋果「服務化+基礎設施化」敘事的最新切片。18 年前,Xserve 敗給了x86 海嘯;18 年後,蘋果帶著自研晶片捲土重來。機房裡的戰爭,才剛剛開始。