法國 AI 實驗室 Mistral 在 10 月 15 日一口氣送上兩份大禮:發表旗下首個時間序列基礎模型家族 Timestral——最大版本僅 209M 參數,便在三大公開基準全數稱王,擊敗 Google 的 TimesFM-3,而且毋須 GPU 即可推論;同日又與歐洲核子研究組織(CERN)簽署戰略合作意向書,要打造史上首個「大型物理模型」(Large Physics Model)。從企業預測到粒子物理,歐洲 AI 正在兩條戰線同時加速。
甚麼是 Timestral?209M 參數的「小鋼炮」
Timestral 是 Mistral 首個時間序列基礎模型(Time-Series Foundation Model)家族,提供機率式(probabilistic)、多變量預測,支援「僅過去」與「已知未來」兩類共變量(covariates)。旗艦版 209M 參數在 GIFT-Eval、TIME 與 fev-bench 三大公開基準上全部排名第一,以約三分之二的參數量擊敗此前最佳成績,手下敗將包括 Google 的 TimesFM-3 與 Falcon-2.0。
整個家族分為 5M、28M、123M、209M 四種尺寸,共用同一架構與訓練配方,每一級都位於「準確度 vs 模型大小」的帕累托前沿(Pareto front)——即同一尺寸下沒有任何公開模型預測得更準:28M 版本已能擊敗體積約四倍的亞馬遜 Chronos-2。更關鍵的是效率:Timestral 推論毋須 GPU,在一般伺服器 CPU 上即可運行。技術上,模型結合合成資料預訓練、共變量感知注意力(covariate-aware attention)與長上下文學習,並可透過 Mistral Forge 微調以適應特定產業。
與傳統方法相比,優勢明顯:ARIMA、線性迴歸等經典模型只能擬合單一序列;深度模型 PatchTST 雖能跨序列學習非線性模式,但每換一個資料集就要從頭訓練。時間序列基礎模型把「預訓練」範式帶入時間序列——在大規模多樣語料上訓練後,能對從未見過的數據進行零樣本(zero-shot)預測,即使該領域數據稀缺也能上手。
CERN 攜手 Mistral:首個對撞機物理基礎模型
同日,CERN 與 Mistral 簽署戰略合作意向書,建立長期夥伴關係。計畫核心是打造單一預訓練的「大型物理模型」——首個對撞機物理基礎模型,以大型強子對撞機(LHC)數十億次模擬質子對撞訓練,任務涵蓋粒子碰撞重建、粒子識別、標記異常訊號,以至評估未來探測器設計。部分外媒報道,該模型代號為「Flare」。
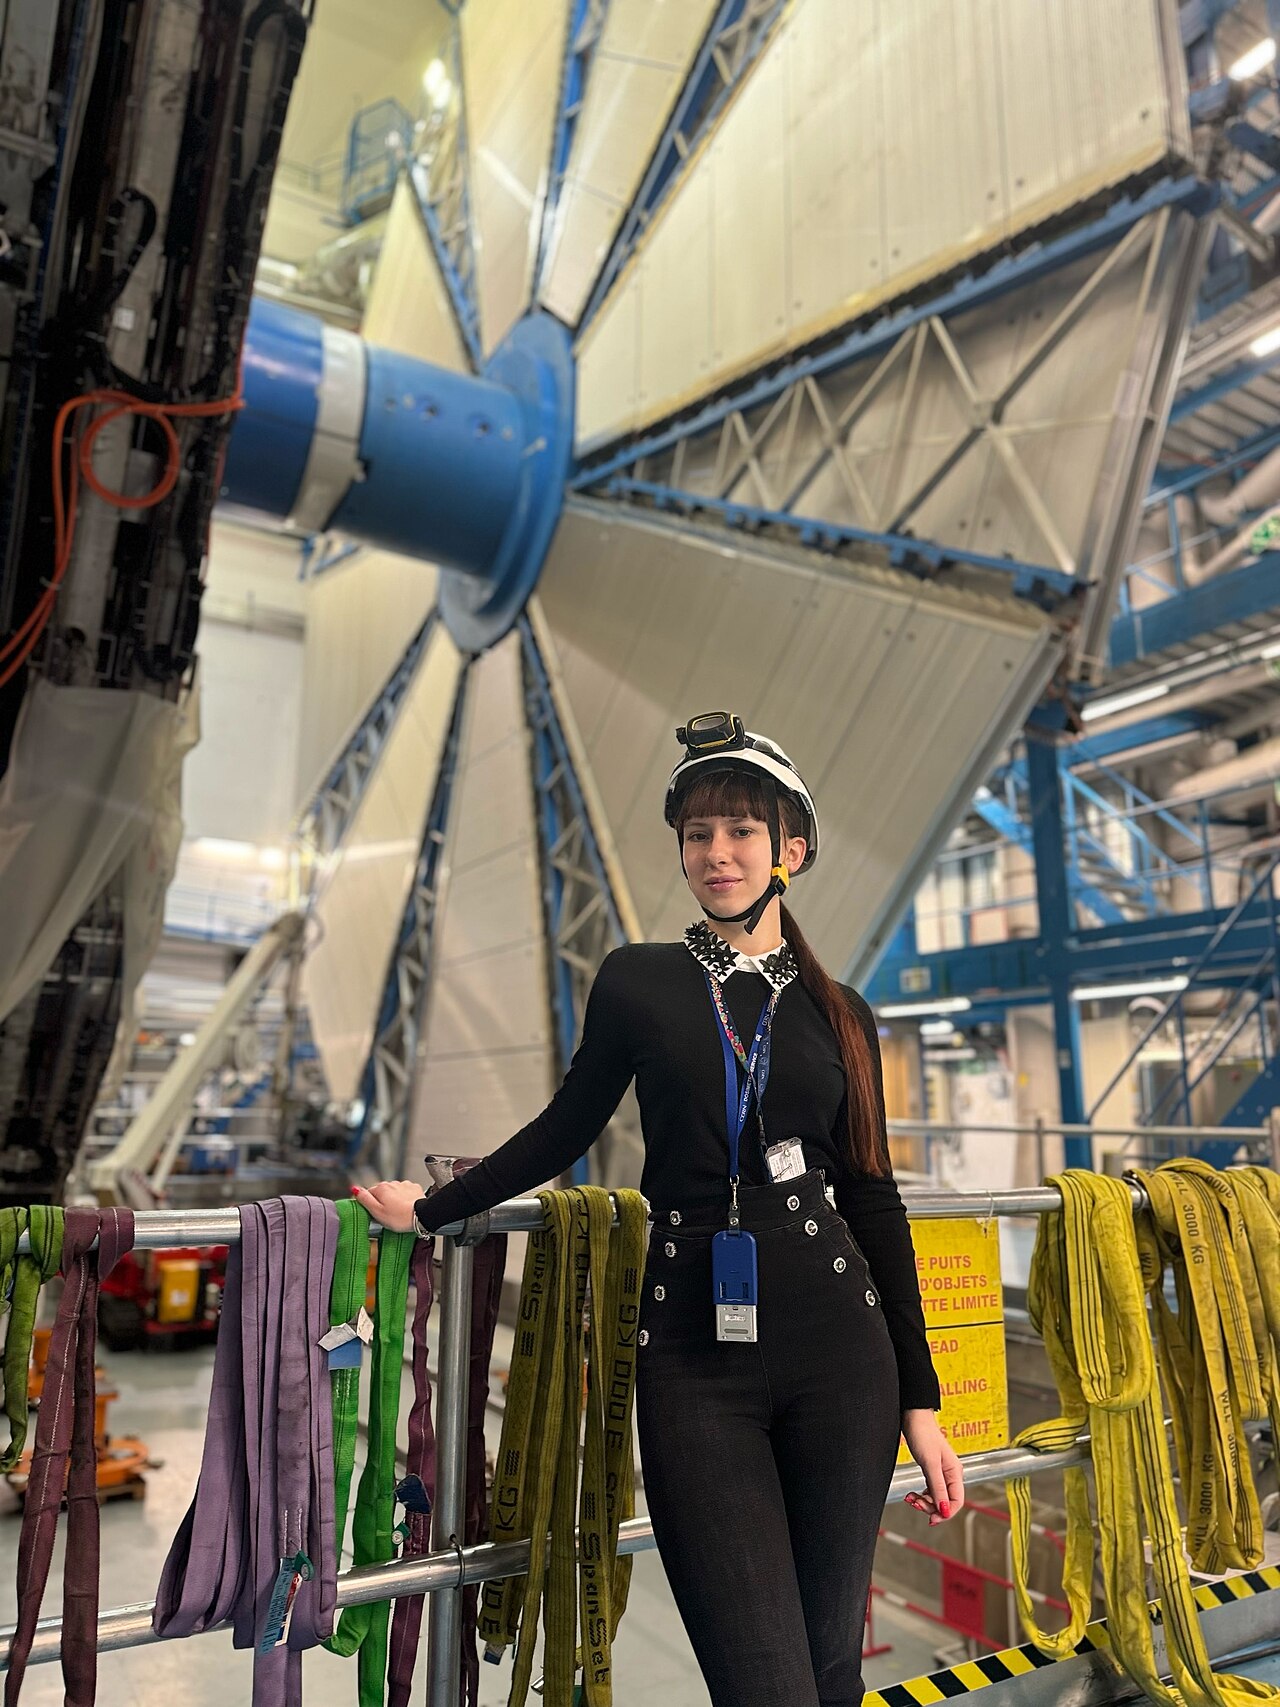
目前 LHC 的碰撞分析依賴一條由專門演算法組成的重建鏈,將探測器訊號逐級轉換為物理分析用的粒子物件;機器學習早已參與個別環節,但基礎模型有機會跨整條重建鏈學習、以單一模型支援多種任務。CERN 資訊長 Enrica Porcani 受訪時表示(編按:Porcari),高能物理為人工智能提供了一個可以「以極端嚴謹度開發與測試」的獨特環境。CERN 至今已儲存約 1 EB(100 萬 TB)的 LHC 實驗數據,而 2030 年前後啟動的高亮度 LHC(HL-LHC)將令對撞次數再增十倍——這種規模與精度的結合,正是訓練科學基礎模型的絕佳土壤。
歐洲 AI 的「科學主權」路線
兩件事同日發生並非巧合。上周 Mistral 才推出歐洲首個萬億參數開源模型 Le Chonk,如今再以 Timestral 與 CERN 合作補上「基礎科學」這塊拼圖。Mistral 工程 AI 副總裁 Johannes Brandstetter 表示,很高興與 CERN 一起探索大規模 AI 模型能為日益複雜的粒子物理帶來甚麼。對照美中在通用大模型上的軍備競賽,歐洲選擇了一條差異化路線:以開放權重(open-weight)、垂直領域與基礎科學的深度結合,建立難以複製的護城河。
對企業而言,Timestral 的意義同樣實在:時間序列是企業最常見的數據類型之一,從感測器遙測、可觀測性指標到財務流量皆屬之。工廠用它預測製程感測器、在設備故障前捕捉漂移;財務團隊用它預測現金流、交易量與波動性。一個毋須 GPU、可零樣本上線、又可微調的預測基礎模型,大幅降低了預測性分析的門檻。
結語
Mistral 一日之內證明了兩件事:模型競賽不在大——209M 參數足以稱霸一個領域;AI 的下一個疆界也不只在聊天——當基礎模型走進對撞機實驗室,誰先掌握「科學級」的 AI 能力,誰就掌握下一輪科學發現的主動權。歐洲這步棋,值得持續關注。